PDF 워드 변환기
이 PDF 워드 변환기는 PDF를 편집할 수 있는 DOCX로 브라우저 안에서 바로 다시 만들어 줍니다. 파일은 변환 내내 내 기기에만 머물고, 계정도 워터마크도 필요 없습니다.
변환은 이 기기에서 이루어집니다. 파일은 어디에도 업로드되지 않습니다.
사용 방법
PDF 추가
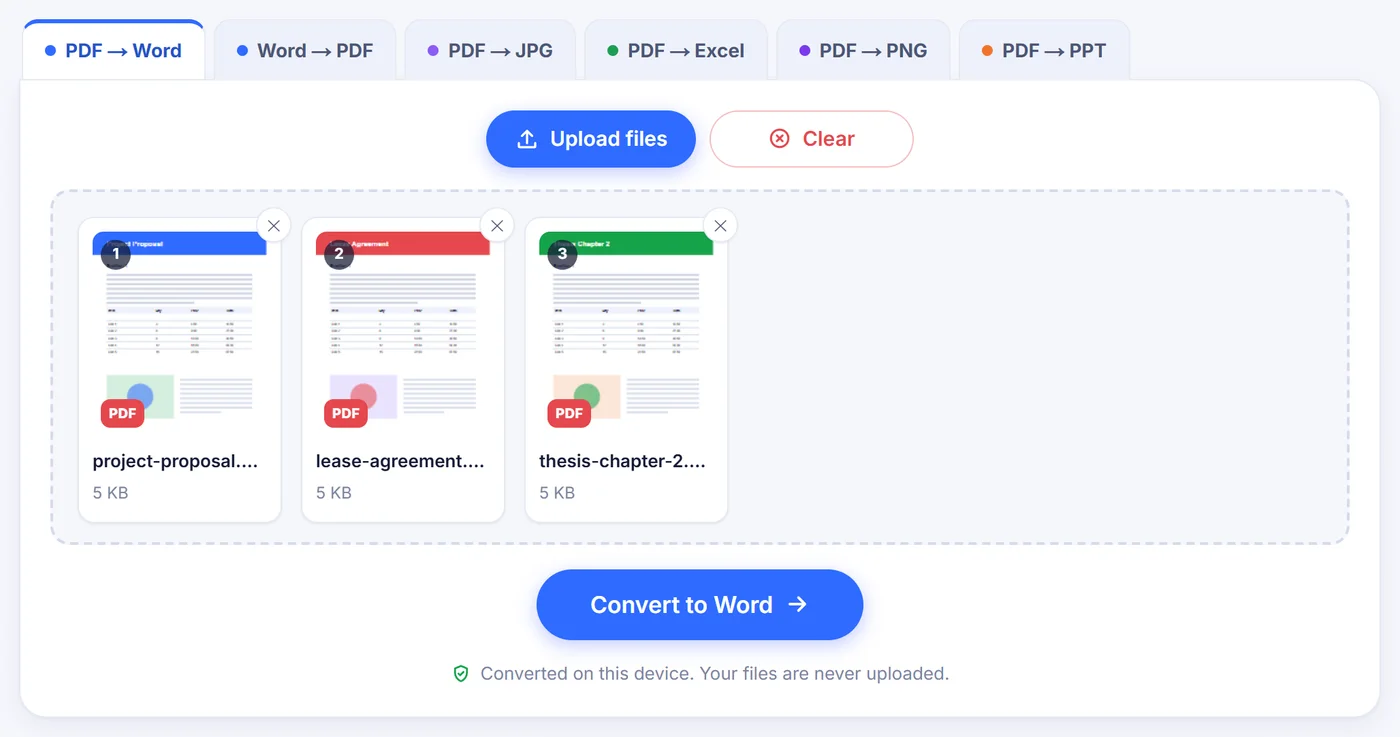
파일 하나만 넣어도 되고 한 번에 최대 20개까지 끌어다 놓을 수 있습니다. 비밀번호가 걸린 PDF는 비밀번호를 묻는데, 입력한 비밀번호는 이 기기 안에서만 사용됩니다.
모드 선택
고쳐 쓸 문서에는 'Editable text'(편집 가능한 텍스트), 서식이나 디자인된 페이지에는 'Exact layout'(레이아웃 유지)을 고르고, 스캔한 페이지라면 OCR도 켭니다.
DOCX 저장
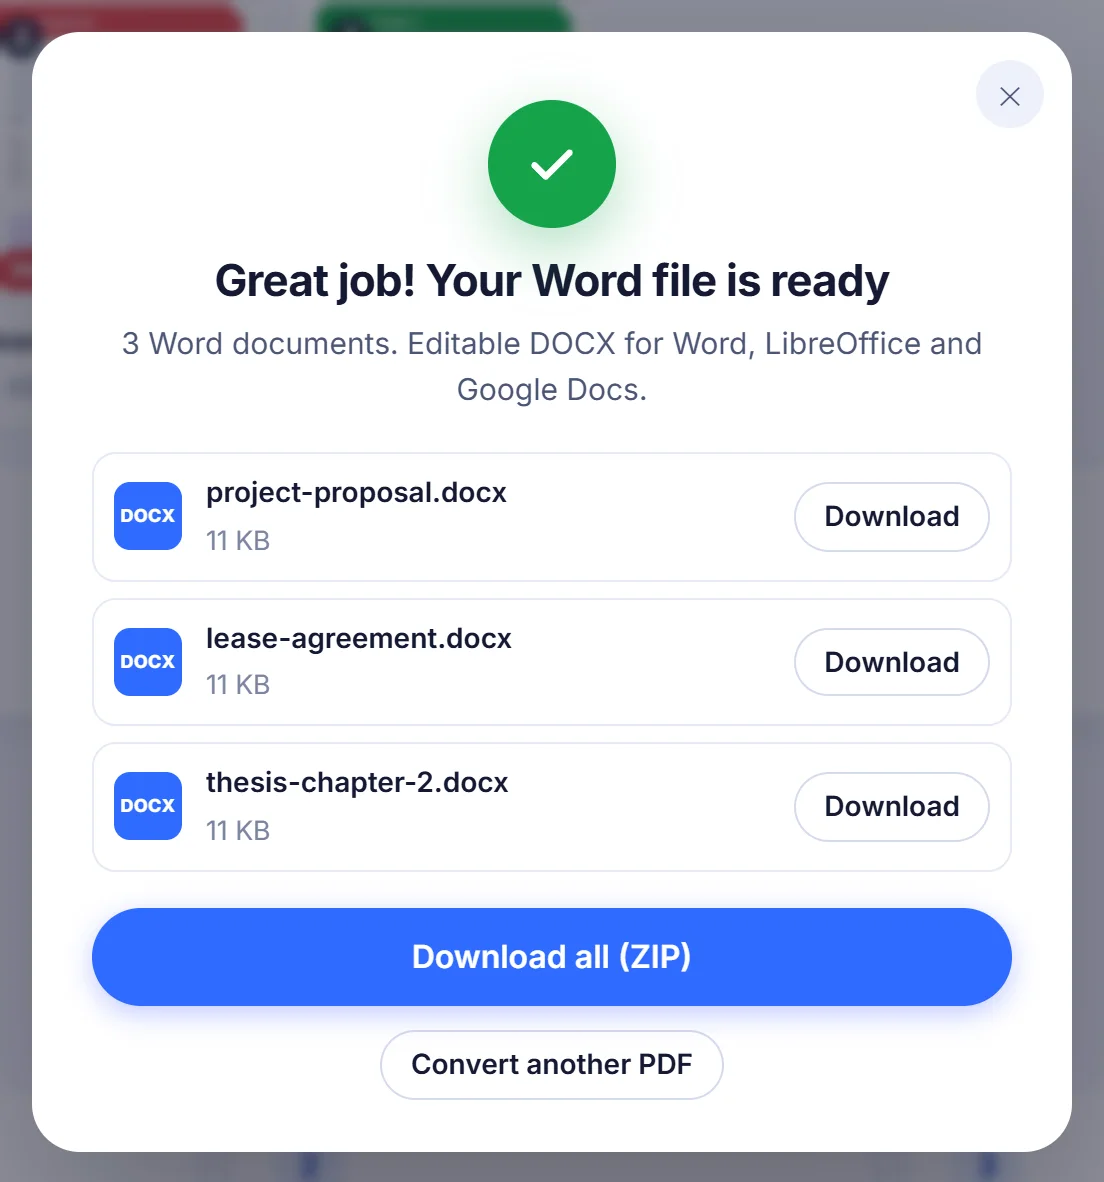
Word 파일을, 여러 개를 변환했다면 ZIP을 다운로드한 뒤 Word, LibreOffice 또는 Google Docs에서 엽니다.
PDF를 Word로 변환하는 이유
PDF는 읽기 위해 만들어진 형식이지, 고쳐 쓰기 위한 형식이 아닙니다. 그 자체로는 문제가 없지만, 날짜 하나가 잘못 들어간 계약서를 받았거나, 3년 만에 이력서를 손봐야 하거나, 지난주에 숫자가 바뀐 보고서를 수정해야 하는 순간이 오면 이야기가 달라집니다. 전부 다시 타이핑하는 일은 느리고 실수도 잦습니다. PDF를 Word 문서로 바꾸면 원래의 글이 진짜 단락으로 되살아나므로, 고쳐야 할 부분만 고치면 됩니다.
그 밖에도 긴 매뉴얼에서 몇 페이지만 다시 쓰고 싶을 때, 브로슈어를 번역할 때, PDF로만 남아 있는 초안에 변경 내용 추적을 넣고 싶을 때, 스캔한 편지를 다시 입력하지 않고 인용하고 싶을 때처럼 흔한 이유도 많습니다.
이 페이지에서 변환이 이루어지는 방식
파일을 추가하면 변환기가 먼저 파일을 열어 앞쪽 몇 페이지를 살펴봅니다. 선택할 수 있는 텍스트가 거의 없으면 스캔 문서로 표시하고 문자 인식을 자동으로 켜 둡니다. 그다음 작은 옵션 창이 뜨고, 아래의 선택지가 나타납니다.
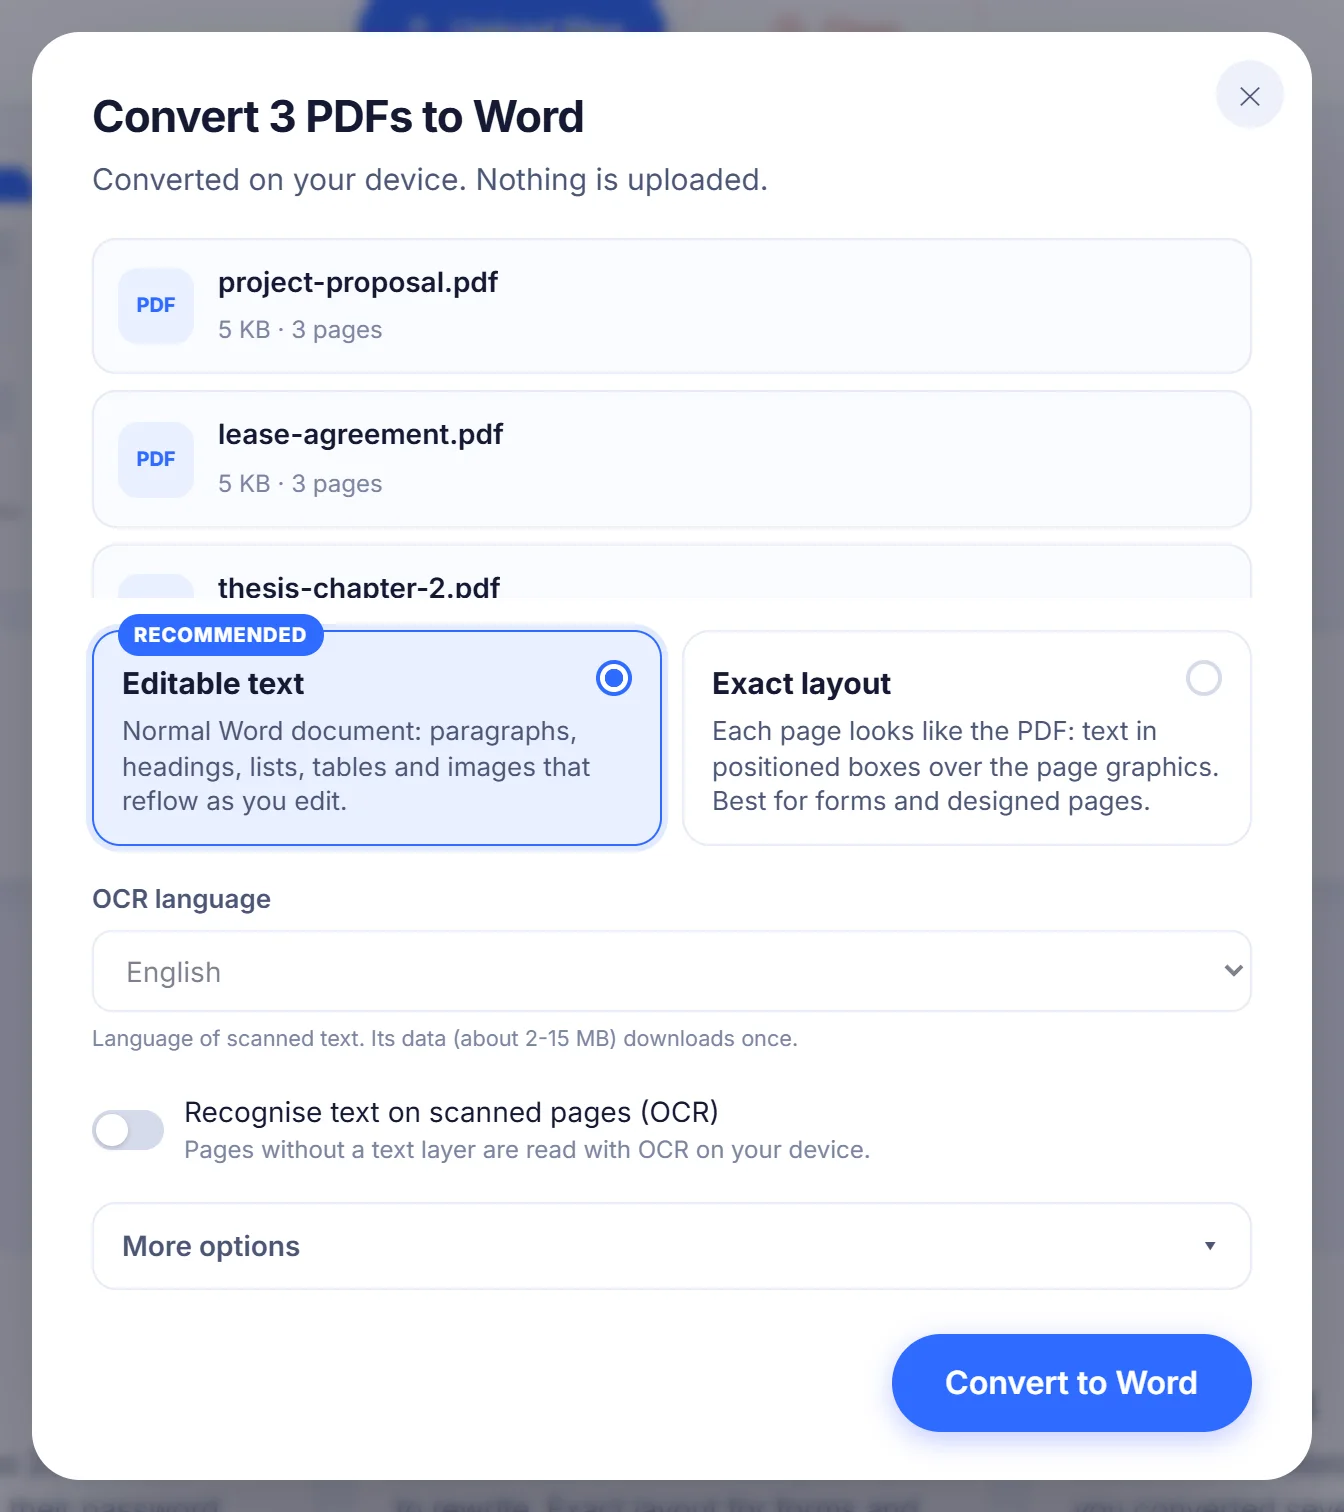
Editable text (편집 가능한 텍스트, 권장)
이 모드는 평범한 Word 문서를 만들어 냅니다. 단의 가장자리에 닿아서 끊겼을 뿐인 줄은 다시 이어져 자연스럽게 흐르는 단락이 되고, 줄 끝에서 하이픈으로 나뉜 단어도 다시 하나로 합쳐집니다. 크거나 굵은 제목은 Word의 실제 제목 스타일이 되어 Word 탐색 창에 문서 구조가 표시됩니다. 글머리 기호 항목은 들여쓰기 수준을 유지한 채 Word 목록이 되고, 열을 맞춰 정렬된 텍스트는 크기를 조절할 수 있는 제대로 된 표로 바뀝니다.
Exact layout (레이아웃 유지)
신청서, 증명서, 전단, 메뉴판처럼 텍스트를 다시 흘려 넣을 일이 없는 PDF도 있습니다. 이런 문서에는 'Exact layout'이 각 페이지의 모습을 그대로 지켜 줍니다. 페이지의 그래픽은 배경에 깔리고, 텍스트 블록 하나하나가 그 위에 위치가 고정된 상자로 올라가며, 편집도 여전히 가능합니다. 다른 편집기는 위치가 지정된 프레임을 덜 안정적으로 다루기 때문에 Microsoft Word나 LibreOffice에서 가장 잘 열립니다.
기타 설정
- Pages (페이지): 파일 하나만 변환할 때는 전체 대신 2-6, 9처럼 범위를 입력할 수 있습니다.
- OCR language (OCR 언어): 영어와 루마니아어부터 아랍어, 일본어, 힌디어까지 28개 언어를 지원합니다. 브라우저 언어가 미리 선택되어 있습니다.
- More options (추가 옵션): 이미지와 도형을 유지하거나 제외하고, 표 감지를 켜거나 끄고, 반복되는 머리글·바닥글·페이지 번호를 Word의 실제 머리글과 바닥글로 옮기고, PDF의 각 페이지를 Word에서도 새 페이지에서 시작하게 하고, 텍스트가 거의 없는 페이지에도 OCR을 실행할 수 있습니다. 'Exact layout'에서는 모든 페이지가 있는 그대로 재현되므로 표, 머리글, 페이지 나누기 스위치가 회색으로 비활성화됩니다.
그대로 유지되는 것과 달라질 수 있는 것
텍스트 서식은 잘 넘어옵니다. 굵게, 기울임꼴, 글꼴 크기, 색상, 위 첨자와 아래 첨자, 정렬과 들여쓰기 모두 그대로입니다. 글꼴 이름도 함께 옮겨지며, 표준 PDF 글꼴은 Word에서 통용되는 대응 글꼴로 바뀝니다. Helvetica는 Arial로, Times는 Times New Roman으로 바뀌는 식입니다. PDF에 설치되지 않은 글꼴이 쓰였다면 Word가 비슷한 글꼴로 대체하므로 줄 길이가 조금 달라질 수 있습니다.
사진은 페이지를 렌더링한 이미지에서 잘라내 JPEG로 저장한 뒤 원래 자리에 삽입되므로, 해상도가 아주 높은 사진은 PDF보다 약간 부드럽게 보일 수 있습니다. 벡터 도형으로 그려진 차트와 로고도 그림으로 담기기 때문에 보기에는 맞지만 Word 차트처럼 편집할 수는 없습니다. 2단으로 짜인 페이지는 단별로 읽어 들이므로, Word의 텍스트가 페이지를 건너뛰지 않고 자연스러운 읽기 순서를 따릅니다.
변환 뒤에 한 번 살펴봐야 할 것들도 있습니다. 셀이 병합되었거나 열 사이 간격이 뚜렷하지 않은 복잡한 표, 기울어진 각도로 쓰인 텍스트(유지되지만 해당 페이지 끝에 일반 텍스트로 들어감), 그리고 번호가 Word의 자동 번호 매기기가 아니라 입력된 글자로 남는 번호 매기기 목록입니다. 'Editable text' 모드에서는 텍스트가 자유롭게 흐르기 때문에 Word의 페이지 수가 PDF와 다를 수 있습니다.
스캔한 PDF와 OCR
스캔은 종이를 찍은 사진일 뿐입니다. 복사할 텍스트가 안에 없기 때문에 변환기가 광학 문자 인식으로 글자를 읽어야 합니다. OCR 스위치를 켠 채로 두고 문서가 쓰인 언어를 고르면, 스캔된 각 페이지가 인식된 뒤 일반 PDF와 같은 단락·표 논리로 배치됩니다. 인식된 텍스트는 문서의 기본 글꼴로 된 일반 텍스트로 들어오므로, 스캔본에 있던 굵게, 기울임꼴, 색상은 직접 다시 적용해야 합니다.
언어 데이터는 언어에 따라 대략 2~15 MB이며, 처음 사용할 때 한 번 다운로드된 뒤 재사용됩니다. 그 순간 연결이 끊기더라도 변환은 끝까지 진행되지만, 스캔 페이지는 이미지로 남고 짧은 안내 문구가 그 이유를 알려 줍니다. 가장 깨끗한 결과를 얻으려면 비뚤어지지 않고 선명한 스캔을 사용하세요. 흐릿한 복사본과 손글씨는 교정이 필요합니다.
자주 생기는 문제 해결
- PDF에 비밀번호가 걸려 있습니다. 어떤 작업도 시작되기 전에 비밀번호를 묻습니다. 입력하면 파일이 열리고, 그 파일을 빼고 싶다면 'Skip'(건너뛰기)을 선택하세요.
- Word 파일에 텍스트가 없습니다. PDF가 스캔본인데 OCR이 꺼져 있었을 가능성이 큽니다. OCR을 켜고 다시 실행해 보세요.
- 아주 긴 문서가 휴대폰에서 멈춥니다. 휴대폰은 컴퓨터보다 메모리가 적습니다. 페이지 범위를 지정해 변환하거나, 수백 페이지짜리 파일은 노트북에서 변환하세요.
- 한 페이지가 손상되어 있습니다. 그 페이지는 Word 파일에서 빈 페이지로 남고 나머지는 그대로 변환되므로, 잘못된 페이지 하나 때문에 전체를 잃지 않습니다.
- 머리글이 본문에 반복해서 나타납니다. 'More options'의 머리글·바닥글 옵션이 켜져 있는지 확인하고 'Editable text'를 선택하세요. 'Exact layout'은 모든 요소를 제자리에 그대로 두기 때문입니다.
여러 파일을 한 번에
PDF를 최대 20개까지 대기열에 넣고 순서를 바꾸거나 제거한 뒤, 같은 설정으로 한 번에 변환할 수 있습니다. 각 파일은 원래 파일 이름을 그대로 가진 별도의 DOCX가 됩니다. 예를 들어 invoice-march.pdf는 invoice-march.docx가 됩니다. 결과가 둘 이상이면 ZIP으로 한꺼번에 받거나 하나씩 다운로드할 수 있습니다. 'Cancel'(취소) 버튼을 누르면 언제든 작업이 중단됩니다.
파일은 내 컴퓨터를 떠나지 않습니다
많은 온라인 변환기는 문서를 원격 서버로 보내 거기서 변환한 뒤 돌려보냅니다. 여기서는 내 브라우저 탭 안에서 실행되는 코드가 작업을 처리하므로 PDF가 어디로도 전송되지 않습니다. 급여 명세서, 진단서, 법률 문서 초안처럼 낯선 사람에게 이메일로 보내지 않을 문서라면 이 점이 중요합니다. 탭을 닫으면 파일과 결과물은 메모리에서 사라집니다.
두 형식에 관한 짧은 메모
PDF는 글자 하나하나를 페이지의 고정된 위치에 저장합니다. 그래서 어디서 열어도 똑같이 보이고, 같은 이유로 편집이 어렵습니다. DOCX 파일은 텍스트를 단락, 스타일, 표로 저장하고 입력하는 대로 다시 흐르게 합니다. 두 형식 사이의 변환은 페이지 위의 위치 정보에서 그런 구조를 다시 세우는 일이며, 이 도구가 페이지마다 하는 일이 바로 그것입니다.
자주 묻는 질문
PDF를 무료로 Word로 변환하려면 어떻게 하나요?
위에서 PDF를 추가하고 'Editable text'를 선택한 뒤 'Word로 변환' 버튼을 누르세요. DOCX가 브라우저에서 바로 다운로드되며, 계정도 워터마크도 없습니다.
스캔한 PDF도 Word에서 편집할 수 있나요?
네, OCR로 읽어 들인 뒤에는 가능합니다. OCR 옵션을 켠 채 문서의 언어를 선택하고, 결과에서 잘못 인식된 글자가 있는지 확인하세요.
내 PDF가 어딘가에 업로드되나요?
아니요. 변환은 브라우저 안에서 실행되므로 문서가 기기 밖으로 나가지 않습니다. OCR 언어 데이터만 처음 필요할 때 한 번 다운로드됩니다.
변환된 Word 문서가 PDF와 다르게 보이는 이유는 무엇인가요?
'Editable text' 모드에서는 단락이 다시 흐르고, 없는 글꼴은 비슷한 글꼴로 대체됩니다. 페이지가 원본과 똑같이 보여야 한다면 'Exact layout'으로 다시 변환하세요.
PDF의 일부 페이지만 Word로 변환할 수 있나요?
네. 파일이 하나일 때 'Pages' 칸에 1-3, 7처럼 범위를 입력하세요. 비워 두면 모든 페이지가 변환됩니다.
비밀번호로 보호된 PDF도 되나요?
비밀번호를 알고 있다면 됩니다. 요청이 뜨면 입력하고, 비밀번호는 파일을 여는 데에만 내 기기에서 사용됩니다.
여러 PDF를 한 번에 DOCX로 변환할 수 있나요?
네, 한 번에 최대 20개까지 됩니다. PDF마다 별도의 Word 파일이 만들어지고, ZIP으로 한꺼번에 다운로드할 수 있습니다.